Caso de Estudio Aurora: Cómo las R8g (Graviton4) casi nos engañan y por qué las R6gd fueron la respuesta correcta.

Como DBAs e ingenieros de la nube, siempre nos entusiasma la última tecnología. Cuando AWS anunció las nuevas instancias R8g impulsadas por los procesadores Graviton4, la tentación fue inmediata. Vimos los benchmarks que prometían un rendimiento de CPU y memoria muy superior , y nuestra migración de instancia parecía obvia: íbamos a saltar a la R8g.
Estábamos equivocados. Y por suerte, nuestras métricas nos lo advirtieron.
Estábamos planeando una migración desde nuestra instancia db.r5.8xlarge y el plan inicial era ir a db.r8g.8xlarge. Más rápido, más nuevo, mejor, ¿verdad? Pero antes de dar el salto, decidimos hacer un análisis profundo de nuestro cuello de botella actual con Performance Insights.
Lo que encontramos cambió toda nuestra estrategia.
El Objeto Brillante: Por qué las R8g nos parecían la opción obvia
Para ser claros, las instancias R8g son bestias de rendimiento. Nuestra atracción inicial estaba completamente justificada.
Rendimiento Puro: Los benchmarks de AWS para cargas de trabajo OLTP (como la nuestra) son impresionantes. Muestran que las R8g (Graviton4) pueden ofrecer hasta 1.7 veces más throughput de escritura y una reducción de latencia de commit de hasta un 46% en comparación con las R6g (Graviton2).
Eficiencia de CPU: Pruebas en cargas de trabajo de bases de datos estándar han mostrado que Graviton4 (en m8g) puede manejar la misma carga que Graviton2 (en m6g) con mucho menos esfuerzo, logrando un 41% más de Consultas por Segundo (QPS) con un 29% menos de latencia.
Precio Atractivo: A pesar de ser más nuevas y rápidas, las R8g a menudo tienen un precio por hora más bajo que las instancias r6gd de la generación anterior (que incluyen el costo del hardware NVMe local).
Mejor rendimiento por menos dinero... ¿qué podría salir mal? Parecía la actualización "automática" perfecta.
La Duda y la Investigación: ¿Cómo funciona el almacenamiento local en Aurora?
Nuestro primer freno fue una duda fundamental: ¿cómo puede una instancia de Aurora usar almacenamiento "local" (como en la r6gd) si toda la arquitectura de Aurora se basa en un volumen de almacenamiento compartido y distribuido? La "d" (de disco local) parecía incompatible con el modelo de Aurora.
Esta duda nos forzó a no asumir nada y a diagnosticar nuestro problema real. Abrimos Performance Insights para nuestra instancia db.r5.8xlarge (Intel, sin disco local) y esto es lo que encontramos:

Este gráfico fue nuestra "pistola humeante". El análisis es claro:
Carga Total (Total DB load): La carga era de 64.88 AAS (Average Active Sessions), más del doble de nuestra capacidad de vCPU (32). La instancia estaba "ahogada".
El Culpable (Wait Events): Miren el desglose de la barra. El evento de espera IO:DataFileRead (en azul claro) representaba 58.95 AAS, o ¡el 91% de toda la carga!
La CPU (CPU): El evento de CPU (en verde) era solo 2.72% del problema.
Conclusión del Diagnóstico: Nuestra base de datos no estaba limitada por la CPU; estaba limitada por I/O (E/S). El sistema pasaba el 91% de su tiempo esperando que el almacenamiento en red de Aurora le entregara las páginas de datos.
Migrar a una r8g con una CPU 1.7 veces más rápida habría sido inútil. Habríamos tenido el procesador más rápido del mundo, pasando el 91% de su tiempo... esperando.
La Solución Correcta: Entendiendo el "Caché por Niveles" de la R6gd
Aquí es donde resolvimos nuestra duda sobre el almacenamiento. La "d" en la r6gd no se usa para los datos principales; eso sigue en el almacenamiento de Aurora. En su lugar, ese disco NVMe local se usa como un Caché de Nivel 2 (L2).
Este diagrama (¡gracias por la imagen!) lo explica todo perfectamente:
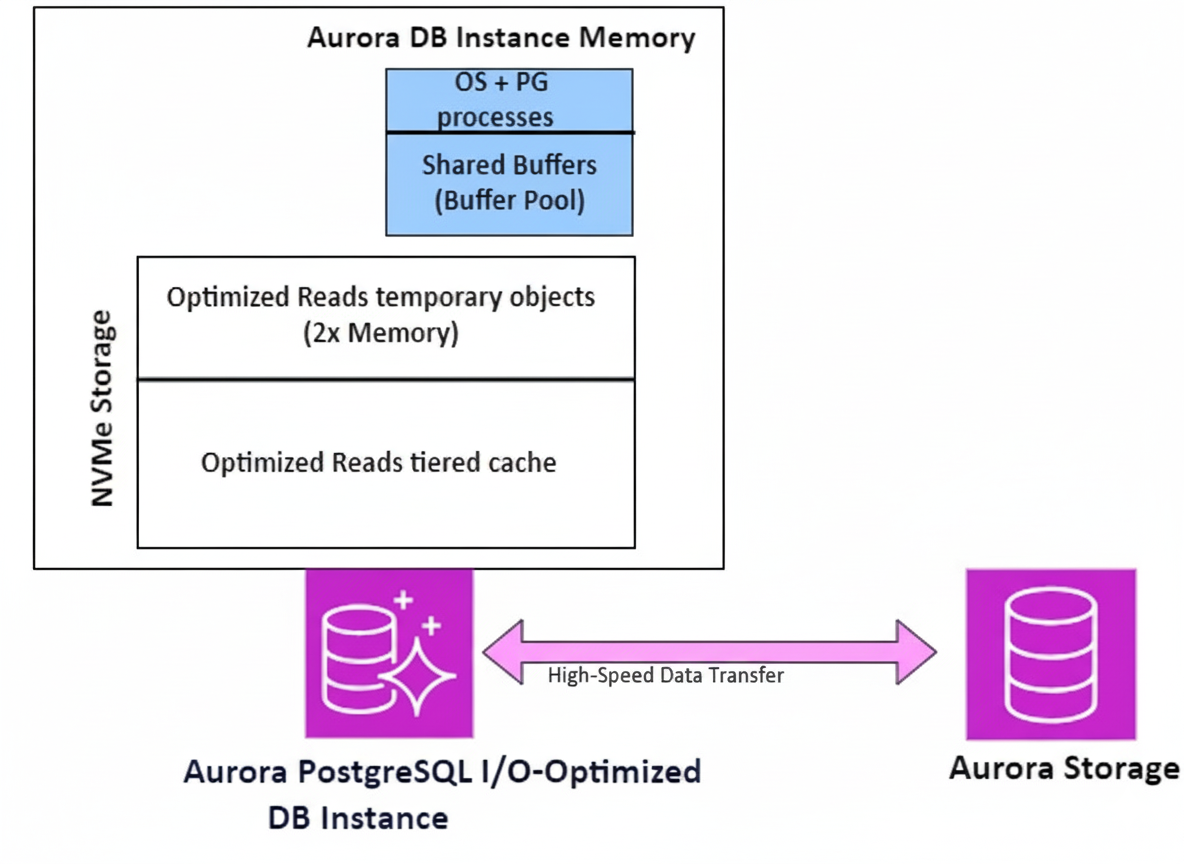
Esta arquitectura crea una jerarquía de caché:
Caché L1 (RAM): El Shared Buffers (Buffer Pool) en la memoria de la instancia. Es el más rápido.
Caché L2 (NVMe Local): El Optimized Reads tiered cache en el disco NVMe de la r6gd. Es muy rápido.
Almacenamiento L3 (Red): El Aurora Storage compartido. Es el más lento.
Nuestro problema (IO:DataFileRead) era un "fallo de caché" L1 que forzaba una lectura lenta desde L3. La r6gd promete convertir esas lecturas de L3 en "aciertos de caché" L2, mucho más rápidos.
La Prueba: Migración a db.r6gd.8xlarge y las Nuevas Métricas
Descartamos la R8g y migramos nuestra db.r5.8xlarge a una db.r6gd.8xlarge del mismo tamaño.
El resultado fue inmediato y espectacular. Miren la misma carga de trabajo en la nueva instancia:
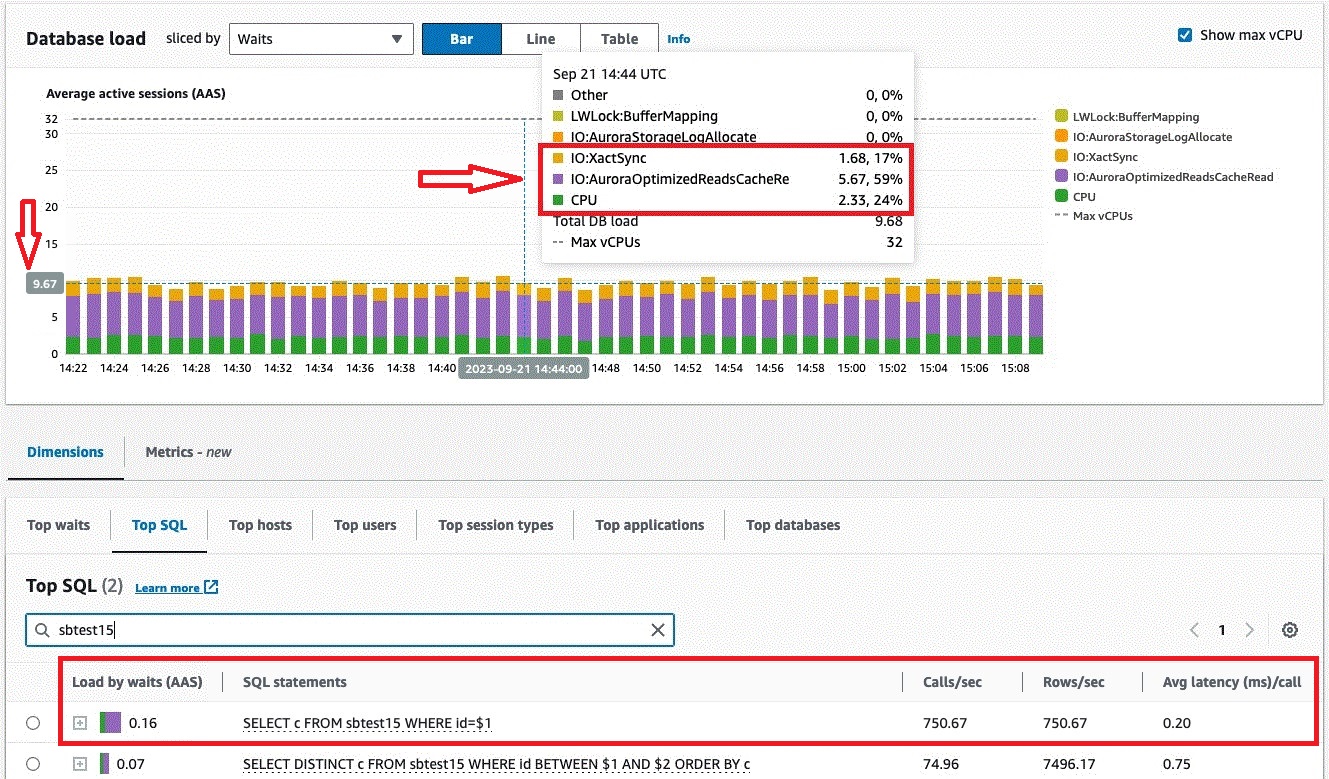
El análisis de la "solución" es elocuente:
Carga Total (Total DB load): La carga total colapsó, pasando de 64.88 AAS a solo 9.67 AAS. La base de datos ahora "respira" con facilidad.
IO:DataFileRead (El Problema): El evento de espera IO:DataFileRead (azul claro) desapareció por completo.
La Nueva Métrica (El Héroe): Fue reemplazado por un nuevo evento de espera dominante: IO:AuroraOptimizedReadsCacheRead (en morado). ¡Esta es la prueba! Este es el nuevo indicador que monitoreamos. Confirma que la base de datos está sirviendo las lecturas desde el Caché NVMe local (L2).
Impacto en Consultas (Top SQL): El impacto en el rendimiento real de la consulta es increíble. La misma consulta SELECT que antes tenía una latencia promedio de 1.84 ms/call ahora se ejecuta en 0.20 ms/call. Una mejora de 9.2 veces en la velocidad.
Apéndice Técnico: ¿Cómo verificar que "Optimized Reads" está activado?
Esto no es magia, requiere dos cosas:
Instancia Correcta: Debes usar una instancia con la "d", como r6gd (Graviton) o r6id (Intel).
Configuración Correcta: Debes estar en el plan de almacenamiento "Aurora I/O-Optimized". Si estás en "Standard", el disco NVMe solo se usa para objetos temporales, no para el caché L2.
Una vez que tienes ambas, puedes conectarte a tu instancia de Postgres y ejecutar este comando para confirmarlo:
SQL
show shared_preload_libraries;
Deberías ver aurora_optimized_reads_cache en la lista, como aquí:
shared_preload_libraries
-------------------------------------------------
rdsutils,pg_stat_statements,aurora_optimized_reads_cache,writeforward
Conclusiones
Esta migración fue un recordatorio crucial de que el benchmark más brillante no siempre es la solución a tu problema.
Lo "Nuevo" no siempre es lo "Mejor": Las R8g son potentes , pero habrían sido la elección equivocada para nosotros. Habríamos pagado por una CPU de F1 para seguir atascados en el tráfico.
Diagnostica tu Cuello de Botella: Los Wait Events no mienten. IO:DataFileRead fue nuestro guía. Identificar si tu problema es CPU-bound o I/O-bound es el paso más importante.
Entiende el Hardware: La "d" en r6gd no es solo "más disco". Es un componente de arquitectura (Caché L2) que puede transformar tu rendimiento si, como nosotros, estás limitado por I/O.
¿Te has enfrentado a un dilema similar? ¿Cómo diagnosticaste tu último cuello de botella? ¡Me encantaría leer tus experiencias en los comentarios!
Nota del Autor:
Este artículo ha sido redactado con la asistencia de Inteligencia Artificial para mejorar la claridad y la estructura. La información sobre los tipos de instancia y las imágenes se han modificado de casos reales para proteger la confidencialidad de la información de las empresas involucradas. Sin embargo, la experiencia práctica, el diagnóstico y la solución descrita se realizaron a cabalidad en un entorno de producción. El objetivo de compartir esta información es ofrecer una guía útil y confirmar con la comunidad que este enfoque puede ser una solución efectiva para problemas de rendimiento similares.
Comments
Join the discussionNo comments yet. Be the first to comment.
